What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO)(驱动 AI 引用的核心因素:生成式引擎优化(GEO)中的内容、检索与模型知识)于 2026-10-10 提交到 arXiv,作者 Mahe Chen, Nick Koudas。去 arXiv 读原文,或下载 PDF。
为什么和被引用有关
- 在涵盖 158,099 个回答和 468,037 次引用的两组 90 天数据中,问答模块、结构化数据和摘要框等常见优化做法在同网站页面对比时没有任何积极效果。
- 页面内容主要通过标题和正文段落契合用户提问来提高引用几率。
- 引擎内部检索阶段解释了同一网站内 32% 的页面引用差异,而页面自身属性仅能解释 2.8%。
- 生成式引擎在每次回答时都会重新改写查询词,其检索返回的结果与传统谷歌或必应搜索结果极少重合。
- 大语言模型自身的先验知识会左右引用结果,模型不仅会优先将已知品牌写入检索词,还会直接在无引用来源的情况下提及已知品牌。
最重要的一点。 AI 引擎是否引用某个网页,主要取决于其自身内部检索能否召回该网页,单纯的页面排版标记并不能带来优势。想要获得 AI 引用,发布者需要让内容在语义上高度契合提问,并在模型认知中建立品牌知名度。
摘要
Generative search engines such as ChatGPT, Gemini and Perplexity now decide which Web pages users see as sources, and a growing industry of generative engine optimization advises publishers on how to earn these citations. We study what shapes citation in two 90-day collections of answers to commercial questions in contrasting markets: 158,099 answers with 468,037 citations. Comparing pages of the same website, content matters in one way: pages whose title and paragraphs match the questions people ask are cited more, whereas FAQ blocks, structured data, summary boxes and page speed appear effective only across websites. Page properties nevertheless explain little of the variation between pages of a website. Replaying the questions through the engines’ APIs shows why. Every page ChatGPT cites is one its own search retrieved, and which pages that search retrieves, for sub-queries the model rewrites on every answer and that rarely coincide with Google’s or Bing’s results, explains far more of the variation than page properties (32% against 2.8%). Content acts mainly through this step, by matching the engine’s queries in meaning. The model’s own knowledge shapes it too: ChatGPT writes brands it knows into its searches, prefers websites it knows, and names brands without any supporting page, and controlled experiments show that brand names reorder its rankings of products with identical facts. Pages are thus cited when searched; brands are also named when remembered. The findings replicate in a market of small B2B vendors. We release data and code.
译文:ChatGPT、Gemini 和 Perplexity 等生成式搜索引擎正在决定向用户推荐哪些网页作为来源,而一个不断发展的生成式引擎优化行业正建议内容发布方如何获取这些引用。我们在两个对比市场中研究了连续 90 天收集的商业问题回答所体现的引用规律:共包含 158,099 个回答和 468,037 次引用。在对比同一网站内的不同页面时,内容特征只在一种情况下起作用:标题和段落与用户提问匹配的页面会获得更多引用,而常见问答模块、结构化数据、摘要框和页面加载速度仅在跨网站对比中看起来有效。然而,页面属性几乎无法解释同一网站不同页面之间的引用差异。通过引擎 API 重放问题揭示了其中的原因。ChatGPT 引用的每个页面都是其自身检索返回的内容;模型为每个回答重新改写子查询,这些检索结果极少与谷歌或必应的搜索结果重合,检索对页面间引用差异的解释力度远超页面属性(32% 对比 2.8%)。内容主要通过该步骤起作用,也就是在语义上匹配引擎的检索词。模型自身的知识也在影响这一过程:ChatGPT 会将自身已知的品牌写入检索词,偏好自身已知的网站,甚至在没有任何支撑网页的情况下直接提及品牌。受控实验表明,在事实完全相同的情况下,品牌名称会重排产品的排序。因此,页面是因为被检索到才获得引用;品牌则是因为被记忆到才被提及。这些结论在小型 B2B 供应商市场中得到了复现。我们公开了相关数据和代码。
关键术语
- 生成式引擎优化:针对生成式 AI 搜索系统的运作机制优化网页内容,以提升页面在 AI 生成答案中的曝光与引用几率的技术实践。
- 检索增强生成:大语言模型在生成最终文本之前,先从外部知识库或网络检索相关文档作为参考的技术架构。
- 站内对比分析:在控制域名权重、权威度与外链完全一致的前提下,仅对比同一网站内部不同页面表现的评估方法。
- 模型先验知识:大语言模型在未进行外部检索之前,由预训练参数所储存的实体认知与偏好。
- 子查询改写:生成式引擎将用户输入的原始提问拆解并重写为多个独立搜索词的自动化检索机制。
论文原文
同网站对比显示,传统优化技巧并未带来引用收益,只有语义匹配能提高引用。
Comparing pages of the same website, content matters in one way: pages whose title and paragraphs match the questions people ask are cited more, whereas FAQ blocks, structured data, summary boxes and page speed appear effective only across websites.
译文:在对比同一网站内的不同页面时,内容特征只在一种情况下起作用:标题和段落与用户提问匹配的页面会获得更多引用,而常见问答模块、结构化数据、摘要框和页面加载速度仅在跨网站对比中看起来有效。
API 重放实验表明,引用差异主要发生在模型自主检索阶段而非页面本身。
Every page ChatGPT cites is one its own search retrieved, and which pages that search retrieves, for sub-queries the model rewrites on every answer and that rarely coincide with Google’s or Bing’s results, explains far more of the variation than page properties (32% against 2.8%).
译文:ChatGPT 引用的每个页面都是其自身检索返回的内容;模型为每个回答重新改写子查询,这些检索结果极少与谷歌或必应的搜索结果重合,检索对页面间引用差异的解释力度远超页面属性(32% 对比 2.8%)。
生成式搜索决定网页曝光的逻辑正在脱离发布者可直接控制的传统指标。
As generative engines become a gateway to the Web, which pages and brands are visible depends on retrieval and model knowledge that publishers cannot observe and that change from week to week.
译文:随着生成式引擎成为进入网络的门户,哪些网页和品牌能够被用户看到,取决于发布者无法直接观察且每周都在变化的检索机制与模型知识。
论文里的图
点状图展示了在控制同一网站后,常见的优化技巧对引用的提升效果降至接近于零。
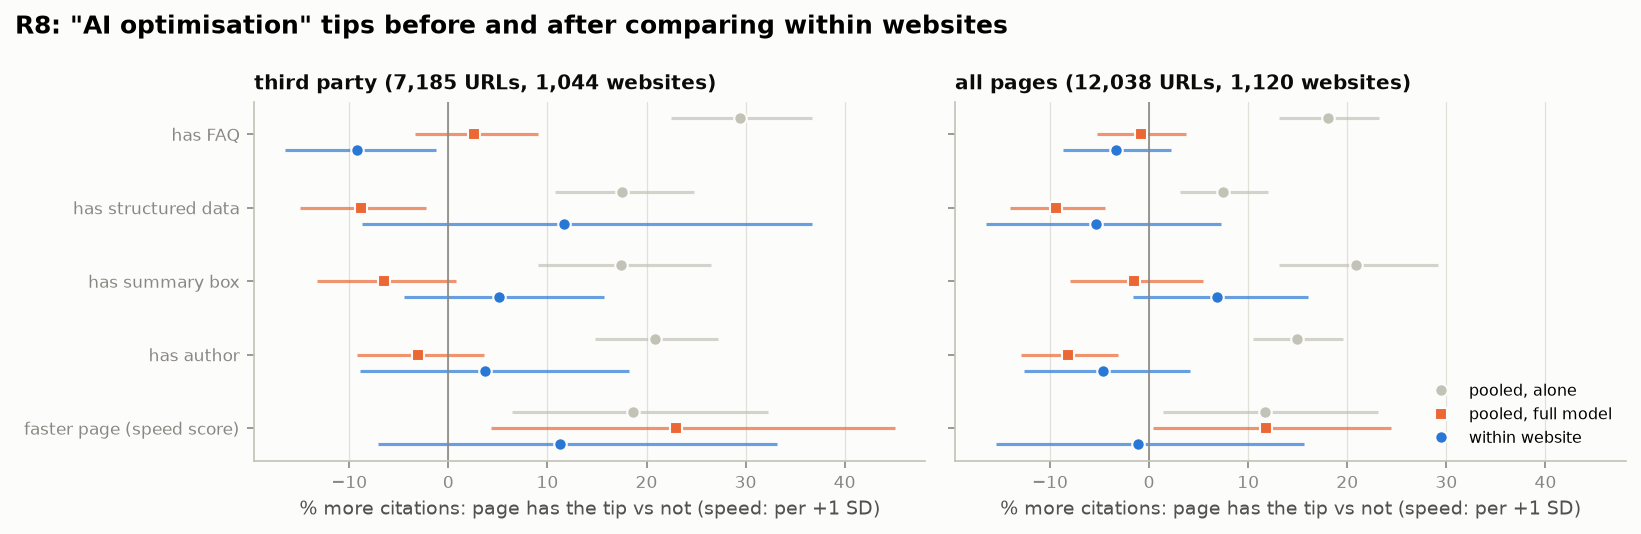
图来自论文 arXiv:2610.15033,版权归作者。原图说明:Figure 1. Effect of recommended practices on citations: across all pages with the practice alone (grey), across all pages with all other features (orange), and comparing pages of the same website (blue), with 95% intervals. Left: third-party pages; right: all pages. Dot plot of the estimated effect of FAQ blocks, structured data, summary boxes, author boxes and page speed under three comparisons; the effects shrink to near zero within websites.
作者自己说的含义
- 依赖结构化标记、问答折叠框等表面样式的 GEO 方法难以在同域名内带来额外引用增益。
- 传统的搜索引擎优化排名不能直接转化为生成式引用,因为 AI 引擎使用的是自主改写的检索词与内部排序。
- 模型内部记忆对商业实体有预设倾向,知名品牌在没有支撑网页的情况下也能被 AI 自然提及。
- 随着引擎改写策略的持续调整,AI 引用的页面结果随时间存在动态漂移,需要进行长期监测。
可以怎么做
- 让网页标题和开头段落直接对齐用户的核心搜索意图。 依据:论文摘要指出,页面标题和段落契合提问是同网站对比中唯一能够有效提升引用的内容特征。
- 停止在页面上堆砌低效的问答折叠块与摘要模块。 依据:摘要结果显示,问答模块、结构化数据和摘要框等特征在排除网站级别差异后无法解释引用优势。
- 将优化重心放在让内容被 AI 内部检索模块命中,而非单一追求传统搜索引擎位次。 依据:论文摘要显示,检索阶段解释了 32% 的页面引用差异,而页面属性仅解释 2.8%。
- 在全网强化品牌实体关联,争取被预训练数据与模型认知采纳。 依据:论文摘要发现,模型会将已知品牌直接写入内部搜索词,并优先推荐已知品牌的网站。
注意。 本研究属于对商业问答数据的观察性研究,没有直接对网站或模型训练展开干预实验,因此相关结论反映的是统计关联而非必然因果关系。
一句话
AI 生成式引擎主要依赖自主检索和预训练知识来决定引用哪些网页。在控制网站本身权重后,常规的格式优化技巧无法带来更多引用。创作者应当聚焦于以清晰的段落准确回应用户提问,并在行业内沉淀长期的品牌认知。
这篇解读根据论文原文写成,发布前有人看过。引用的段落是原话,数字都是作者自己报告的。方法和完整结果请读论文。