这是 Sourso 团队的论文。我们在研究栏目里按发现拆开写了解读。 读解读 →
Understanding ChatGPT Citations: Evidence from Production Web Search Across Model Generations(理解 ChatGPT 引用:来自多代模型线上网页搜索的实证研究)于 2026-10-11 提交到 arXiv,作者 Yunxuan Jiang, Shiqi Zhang, Anqi Xing, Xiangyu Chang, Xiaokui Xiao。去 arXiv 读原文,或下载 PDF。
为什么和被引用有关
- 在多次重复运行中,被 ChatGPT Web 检索次数更多的候选网页,最终被选为引用的概率也更高。
- 把谷歌搜索和 OpenAI Responses API 结合起来,也只能找回 ChatGPT Web 所引用网址的大约四分之一。
- 外部搜索代理在域名和实体层面上与 ChatGPT Web 引用结果更相符,而在具体网址层面的吻合度较低。
- 在外部代理召回的候选集合中,结合代理信号的监督模型在 GPT-5.3 和 GPT-5.5 上的网址、域名与实体三个层级均达到了 0.74 以上的 AUC。
- Instant 模式主要维持单轮检索,而 GPT-5.4 Thinking 模式经常会开展多轮检索。
最重要的一点。 生成式引擎优化需要区分检索可见度与引用可见度,因为网页被检索到并不代表会被最终回答引用。团队应当在多次运行中关注域名和实体层面的出现情况,避免只看单次运行的具体网址。
摘要
Generative engines such as ChatGPT Web retrieve webpages to answer user queries, but only a subset are shown as citations. Understanding this retrieval-to-citation process is important for generative engine optimization (GEO), which aims to improve content visibility in generative-engine responses. However, prior studies mainly analyze final responses, leaving the internal execution process and its variation across model settings less understood. To this end, we conduct an observational study of four ChatGPT Web settings from ChatGPT 5.2 to 5.5, covering Instant and Thinking modes at the URL, hostname, and entity levels. We examine how ChatGPT rewrites queries, retrieves candidate webpages, and selects references. The Instant settings remain mostly single-round, while GPT-5.4 Thinking frequently performs multiple retrieval rounds. Across repeated runs, candidates retrieved more often are also more likely to be cited. We then evaluate Google Search and the OpenAI Responses API as external proxies. Responses API candidates provide broader coverage, while its citations more closely match sources cited by ChatGPT Web. Both proxies match ChatGPT Web better at the hostname and entity levels than at the exact-URL level. Even when combined, they recover only about one quarter of cited URLs. We further test whether these external signals remain predictive when combined. Within the external candidate set, a supervised model combining them reaches AUCs above 0.74 for GPT-5.3 and GPT-5.5 at all three levels. These findings suggest that GEO should distinguish retrieval visibility from citation visibility, account for rewritten queries and run-to-run variation, and consider hostname- and entity-level presence in addition to exact URLs. Differences across settings also suggest that GEO strategies should be re-evaluated when the deployed setting or serving environment changes.
译文:像 ChatGPT Web 这样的生成式引擎会检索网页来回答用户的问题,但只有一部分网页会作为引用展示出来。理解从检索到引用的整个过程,对旨在提升内容在生成式引擎回答中曝光率的生成式引擎优化(GEO)非常重要。然而,以往的研究大多只分析最终的回答,对内部的执行流程以及不同模型设置之间的差异缺乏了解。为此,我们针对 ChatGPT 5.2 到 5.5 的四个 ChatGPT Web 设置展开了一项观察研究,涵盖了即时模式与思考模式,并在网址、域名和实体三个层级进行分析。我们调查了 ChatGPT 如何改写查询、检索候选网页以及挑选参考来源。即时模式设置基本保持单轮检索,而 GPT-5.4 思考模式则频繁进行多轮检索。在多次重复运行中,被检索次数更多的候选网页也更容易被引用。随后,我们评估了谷歌搜索和 OpenAI Responses API 作为外部代理的效果。Responses API 的候选网页覆盖范围更广,而它的引用结果与 ChatGPT Web 所引用的来源更加吻合。两种代理在域名和实体层级上与 ChatGPT Web 的匹配程度都好于具体网址层级。即便把它们结合在一起,也只能找回大约四分之一的被引用网址。我们进一步测试了这些外部信号组合在一起时是否仍具有预测价值。在外部候选集合中,融合这些信号的监督模型在 GPT-5.3 和 GPT-5.5 上,于全部三个层级都取得了 0.74 以上的 AUC。这些发现表明,GEO 应当区分检索可见度与引用可见度,重视改写后的查询和多次运行带来的变化,并在具体网址之外兼顾域名和实体层面的存在。不同设置之间的差异也说明,当线上部署的设置或服务环境发生改变时,需要重新评估 GEO 方法。
关键术语
- Generative Engine Optimization (GEO):生成式引擎优化,指通过调整网页内容,使其更容易被生成式引擎检索并在回答中引用的做法。
- Server-Sent Events (SSE):服务器发送事件,一种允许服务器通过单个连接持续向浏览器推送文本更新的网络技术。
- Responses API:OpenAI 提供的程序接口,允许开发者开启网页搜索并查看候选来源与引用信息。
- Area Under the ROC Curve (AUC):受试者工作特征曲线下面积,用来衡量模型把被引用来源排在未被引用来源前面的能力。
- Thinking Mode:思考模式,指模型在给出最终回答前先进行长思考并执行多次检索的工作模式。
论文原文
作者强调搜索可见度与引用可见度是两回事。
A source may therefore appear in external search or retrieval results without being cited by ChatGPT Web, let alone appearing as a displayed citation. GEO should distinguish retrieval visibility from citation visibility rather than treat search ranking as the final objective.
译文:因此,某个来源可能会出现在外部搜索或检索结果中,却没有被 ChatGPT Web 引用,更谈不上作为可见引用展示给用户。GEO 应当区分检索可见度与引用可见度,避免把搜索排名当成最终目标。
研究人员指出可见度监测必须考虑改写后的查询和多次运行。
GEO monitoring should therefore consider the executed queries rather than only the user-facing query. Repeated runs are also necessary because candidate sets vary substantially across responses, while candidates retrieved more often across runs are more likely to be cited (Figures 2 and 3 ).
译文:因此,GEO 监测应当考虑实际执行的查询,而不能只看面向用户的提问。进行多次运行也是必要的,因为候选集合在不同回答之间存在很大波动,而在多次运行中被检索频率更高的候选来源也更有可能被引用(图 2 和图 3)。
作者提醒观察到的关联并不能证明检索频次能直接导致引用。
These results are observational and do not imply that publishing more pages or making a source appear more often in retrieval will increase its likelihood of being cited.
译文:这些结果属于观察性发现,并不意味着发布更多页面或让某个来源在检索中出现得更频繁就一定会提高它被引用的概率。
论文里的图
该图展示了从查询改写到候选网页检索与引用选择的完整执行流程,以及外部代理评估方式。
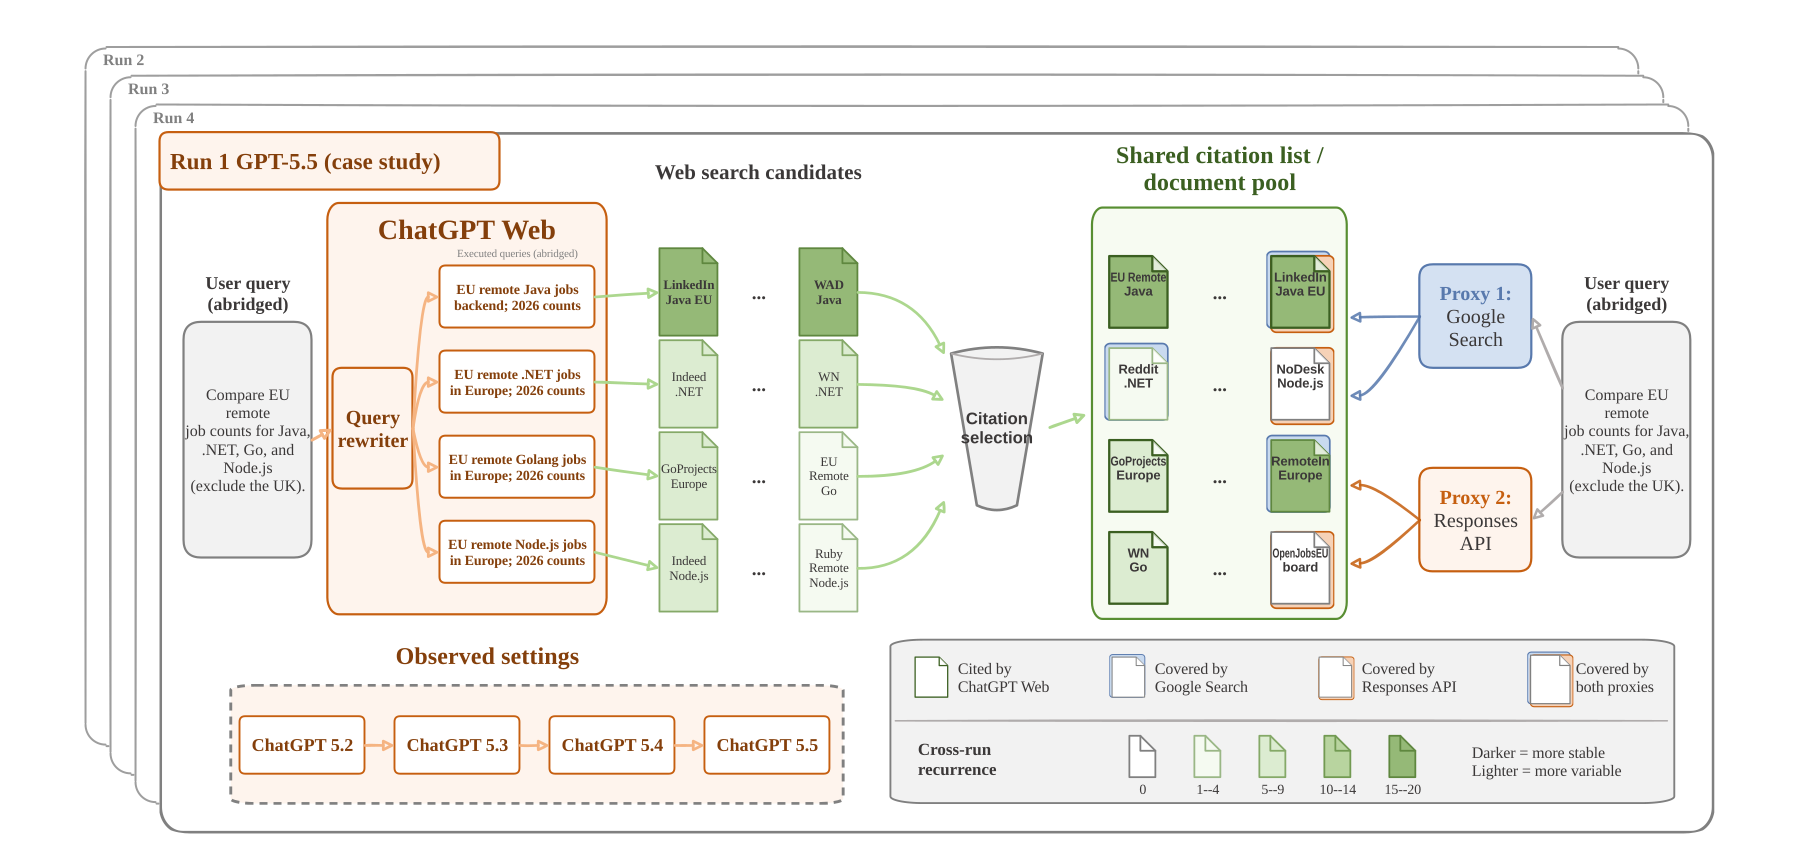
图来自论文 arXiv:2610.15382,版权归作者。原图说明:Figure 1 . Overview of ChatGPT Web probing and proxy evaluation. The GPT-5.5 run is an abridged case study. Document darkness encodes cross-run occurrence. Blue marks Google Search coverage; orange marks Responses API coverage.
作者自己说的含义
- 搜索排名本身不能当作生成式引擎可见度的最终衡量标准,因为生成式引擎在挑选引用前会进一步筛选候选网页。
- 针对生成式引擎进行优化时,需要跟踪系统实际执行的内部查询,而不能只看用户输入的原始问题。
- 统计域名和实体层面的展示情况比追踪单个具体网址更加稳定,因为不同运行之间的网址候选集差异很大。
- 每当底层模型设置或线上部署环境发生变动,团队都需要重新评估现有的优化方案。
可以怎么做
- 在多次独立运行中衡量内容的曝光情况。 依据:在多次重复运行中,被检索次数更多的候选网页最终被引用的概率更高。
- 在监测具体网址的同时持续跟进域名和品牌实体的出现频率。 依据:外部搜索代理在域名和实体层面与引用来源更贴近,而在具体网址层面只能覆盖大约四分之一的引用。
- 分析表现时调出引擎内部改写后的查询语句进行检查。 依据:ChatGPT Web 在检索前会重写用户问题,且 Instant 模式与 Thinking 模式的检索轮数明显不同。
注意。 本项研究纯属对四个模型设置的观察分析,并没有测试修改网页内容后的实际效果,因此无法证明哪些因素直接导致了引用产生。
一句话
ChatGPT Web 将网页检索与引用挑选分成不同步骤,出现在搜索结果中并不保证网页会被最终引用。外部工具只能找回大约四分之一的被引用网址,但在域名和实体层面上能提供更稳定的参考依据。营销人员和研究人员在做生成式引擎优化时,必须考虑查询改写、多次运行的波动以及模型版本的更替。
这篇解读根据论文原文写成,发布前有人看过。引用的段落是原话,数字都是作者自己报告的。方法和完整结果请读论文。